
一、书籍档案
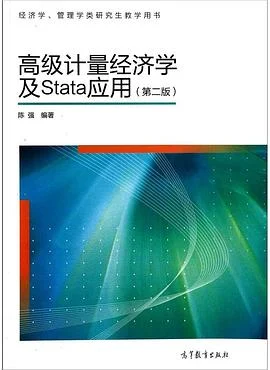
| 书名 | 高级计量经济学及Stata应用(第二版) | ||
| 作者 | 陈强 | ||
| 译者 | 无(中文原创) | ||
| 出版社 | 高等教育出版社 | 出版时间 | 2014年4月 |
| ISBN | 9787040329834 | 定价 | 59.00元(平装) |
| 豆瓣评分 | 9.7分(493人评价) | 微信读书 | 96.2%(26人点评) |
二、全书概要
这本书的论证主线:计量经济学是用数据验证经济理论与政策效果的”证据科学”——从”你凭什么说X导致了Y”这个问题出发,全书教你把因果关系从数据里”挖”出来。内容分四大板块:一是横截面数据方法(多元回归、工具变量、广义矩估计GMM、极大似然估计、离散选择模型Probit/Logit、分位数回归、门限回归、非参数估计);二是面板数据方法(固定效应、随机效应、长面板、动态面板、非线性面板)——利用”同一批对象多年追踪”识别因果;三是时间序列方法(VAR向量自回归、单位根、协整)——研究变量随时间的联动与长期关系;四是现代应用(自然实验与双重差分、处理效应、空间计量、久期分析、贝叶斯估计)。每一章都遵循同一套路:理论推导(为什么要这么估计)→ 模型设定(怎么建模)→ Stata实操(命令怎么写)→ 结果解读(输出怎么读)。它回答的核心问题是:如何用Stata把严谨的因果识别做出来,并让对方信服。
三、颠覆你认知的三个地方
- “相关不等于因果”不是一句口号,是一整套技术。陈强系统教你怎么用工具变量、双重差分、断点回归把”伪相关”拆穿——这是全书最核心的”反常识”。
- 回归结果的显著性,可能是”自我欺骗”。内生性(反向因果、遗漏变量、测量误差)会让估计彻底失真——一个”显著”的系数,可能方向都是错的。
- 数据说不了话,是”识别策略”让它说话。同样的数据,不同的识别策略得出不同结论——计量经济学的精髓不在算,在”设计”:你凭什么认为这个变化是”外生的”?
四、作者真正想说的话
陈强真正想说的是:实证研究的核心不是”跑回归”,是”识别因果”——研究者必须回答一个致命问题:你观察到的相关性,凭什么能被解释为因果关系?他反复强调:现代计量经济学的一切工具(工具变量、双重差分、面板固定效应、自然实验),都是在回答同一个问题——”反事实”是什么?如果处理组没被干预,它本来会发生什么?
他的立场是”应用导向的严谨”:不堆砌数学推导(该讲的地方讲透),不回避现实数据的不完美(专门教你怎么用稳健标准误、自助法、蒙特卡罗应对),每一讲都以”能跑出结果、能解释结果”为终点。他写给读者的不是”看懂计量”,是”会用计量做研究、看穿别人的研究”——这种实战化定位,正是它在经管研究生中封神的原因。
五、值得细读的章节
- 关于”内生性与工具变量”的章节:全书精华——理解”相关≠因果”的钥匙,必读。
- 关于”面板数据与固定效应”的章节:实证研究最高频的方法,识别个体异质性影响的主力工具。
- 关于”双重差分与自然实验”的章节:政策评估的”黄金标准”,当代应用计量最热门方法。
- 关于”Stata实操与结果解读”的部分:贯穿全书的实战价值所在——命令与输出解读,边读边跑。
六、阅读过程中的感悟
- 读”内生性”一章,我经历了研究者的”信仰崩塌”。我过去做分析,看到回归系数显著就兴奋,以为找到了答案。陈强当头一棒:你的解释变量可能被反向因果污染、被遗漏变量扭曲——一个”漂亮显著”的结果,可能只是把垃圾数据跑出了幻觉。我回去复查自己过去的一份报告,发现最关键的结论确实存在内生性嫌疑:不是”我们提升了业绩”,而是”业绩好的部门本来就更容易获得资源”。那一刻我才明白:不是数据骗人,是我的识别策略太天真。
- 读”工具变量”,我第一次理解什么叫”设计一个准实验”。陈强教:找一个”只影响X、不影响Y(除通过X)”的变量,用它做”自然随机化”。我印象最深的是他用”距离”做工具变量的例子——距离学校近的学生更容易受教育,而距离本身不影响收入。这套”借大自然的随机”的思路,让我对”因果识别”有了画面感:原来严谨的因果,不是喊出来的,是设计出来的。此后我做任何”归因分析”,第一反应都是:这里有没有一个工具变量能借用?
- 读”面板数据与固定效应”,我的分析能力上了一个台阶。以前我用横截面数据,总被”不同人的特质差异”干扰。陈强教我用固定效应:让每个人做自己的”对照组”,把不随时间变的个人特质全部”差分掉”。我在自己的业务数据上试跑,结论立刻清晰了很多——原来业绩差异主要来自”人的特质差异”而非”策略差异”。这个发现直接改变了我做管理决策的方式:与其指望一招制胜的策略,不如先解决”人的结构性差异”。计量方法,居然帮我看清了管理问题的本质。
- 最触动我的是”结果解读要诚实”的部分。陈强反复强调:不显著也是结果、稳健性检验要主动做、不能”跑数据挑结论”。这跟我见过的很多”先有结论再找数据”的做法完全相反。我反思自己过去写报告的习惯——常常不自觉只呈现”好看的结果”。读了这本书,我给自己立了规矩:任何分析,先看全貌(含不利证据),再下结论;结论要经得起”换一种识别策略”的检验。这种诚实,让我在内部汇报里少走了很多弯路。
- 读完最大的感受:这本教材给我的不是”更多回归技巧”,是一整套”证据思维”。相关不等于因果、内生性无处不在、识别策略决定结论、稳健性必须检验——这些原则,让我看任何数据报告(研究报告、市场分析、政策解读)都有了”质检”的眼光。我最大的收获:从”信数据”变成”审数据”——先问识别策略、再问稳健性、最后才信结论。对任何要做严谨分析、或要辨别别人结论真伪的人,这是值得反复翻阅的一本”证据科学教科书”。
七、这本书应该怎么读
- 先补基础再读本书。建议先读陈强《计量经济学及Stata应用》(中级版)建立OLS与假设检验基础,再进本书。
- 必须边读边跑Stata。本书每章配有实操命令——用自带或自备数据逐章跑通,才算真学会。
- 重点死磕”内生性与工具变量””双重差分”两章。这是全书精华,也是实证研究的核心方法论。
- 适合经济学/管理学研究生、博士生、科研人员、数据分析师、政策评估者,以及一切需要”用数据证明因果”的人读。零计量基础者慎入;愿意投入一学期系统训练的人,会收获一套稀缺的”因果识别”硬技能。
八、读前决策
《经济学、管理学类研究生教学用书:高级计量经济学及Stata应用(第二版)》较多地借鉴了现代计量经济学的最新发展,内容全面,除了介绍传统的横截面数据外,对面板数据(含长面板、动态面板、非线性面板)、时间序列(含VAR、单位根、协整)、自然实验、重复截面数据、GMM、自助法、蒙特卡罗法、分位数回归、门限回归、非参数估计、处理效应、空间计量、久期分析、贝叶斯估计等均做了较深入的分析。此书力图以生动的语言、较多的插图与经济意义来直观地解释计量方法,而又不失数学的严谨性。同时,结合目前欧美最为流行的Stata计量软件,及时地介绍相应的Stata命令与实例,为读者提供“一站式”服务。此书适合普通高等学校经济学、管理学类或社科类硕士生、博士生与研究人员使用。为便于读者学习高级计量经济学,《经济学、管理学类研究生教学用书:高级计量经济学及Stata应用(第二版)》在内容安排上,假设读者已经学过微积分、线性代数与概率统计,但不要求学过本科阶段的计量经济学(学讨百好)。
第1章绪论
1.1什么是计量经济学
1.2经济数据的特点与类型
第2章概率统计回顾
2.1概率与条件概率
2.2分布与条件分布
2.3随机变量的数字特征
2.4迭代期望定律
2.5随机变量无关的三个层次概念
2.6常用连续型统计分布
2.7统计推断的思想
习题
附录
第3章小样本OLS
3.1古典线性回归模型的假定
3.2OLS的代数推导
3.3OLS的几何解释
3.4拟合优度
3.5OLS的小样本性质
3.6对单个系数的t检验
3.7对线性假设的F检验
3.8F统计量的似然比原理表达式
3.9分块回归与偏回归(选读)
3.10预测
习题
附录
第4章Stata简介
4.1为什么使用Stata
4.2Stata的窗口
4.3Stata操作实例
4.4Stata命令库的更新
4.5进一步学习Stata的资源
习题
第5章大样本OLS
5.1为何需要大样本理论
5.2随机收敛
5.3大数定律与中心极限定理
5.4统计量的大样本性质
5.5渐近分布的推导
5.6随机过程的性质
5.7大样本OLS的假定
5.8OLS的大样本性质
5.9线性假设的大样本检验
5.10大样本OLS的Stata命令及实例
习题
附录
第6章最大似然估计法
6.1最大似然估计法的定义
6.2线性回归模型的最大似然估计
6.3最大似然估计的数值解
6.4信息矩阵与无偏估计的最小
方差
6.5最大似然法的大样本性质
6.6最大似然估计量的渐近协方差矩阵
6.7三类渐近等价的统计检验
6.8准最大似然估计法
6.9对正态分布假设的检验
6.10最大似然估计法的Stata命令及实例
习题
附录
第7章异方差与GLS
7.1异方差的后果
7.2异方差的例子
7.3异方差的检验
7.4异方差的处理
7.5处理异方差的Stata命令及实例
7.6Stata命令的批处理
习题
附录
第8章自相关
8.1自相关的后果
8.2自相关的例子
8.3自相关的检验
8.4自相关的处理
8.5处理自相关的Stata命令及实例
习题
第9章模型设定与数据问题
9.1遗漏变量
9.2无关变量
9.3建模策略:“由小到大”还是“由大到小”
9.4解释变量个数的选择
9.5对函数形式的检验
9.6多重共线性
9.7极端数据
9.8虚拟变量
9.9经济结构变动的检验
9.10缺失数据与线性插值
9.11变量单位的选择
习题
附录
第10章工具变量,2SLS与GMM
10.1解释变量与扰动项相关的例子
10.2工具变量法作为一种矩估计
10,3二阶段最小二乘法
10.4有关工具变量的检验
10.5GMM的假定
10.6CMM的推导
10.7GMM的大样本性质
10.8如何获得工具变量
10.9MLE也是GMM
10.10工具变量法的Stata命令及实例
习题
附录
第11章二值选择模型
11.1离散被解释变量的例子
11.2二值选择模型
11.3二值选择模型的微观基础
11.4二值选择模型中的异方差问题
11.5稀有事件偏差(选读)
11.6含内生变量的Probit模型(选读)
11.7双变量Probit模型(选读)
11.8部分可观测的双变量Probit模型(选读)
习题
第12章多值选择模型
12.1多项Logit与多项Probit
12.2条件Logit模型
12.3混合Logit模型
12.4嵌套Logit
习题
第13章排序与计数模型
13.1排序模型
13.2泊松回归
13.3负二项回归
13.4零膨胀泊松回归与负二项回归
13.5计数模型的Stata实例
习题
第14章受限被解释变量
14.1断尾回归
14.2零断尾泊松回归与负二项回归
14.3随机前沿模型(选读)
14.4偶然断尾与样本选择
14.5归并回归
14.6归并数据的两部分模型
14.7含内生解释变量的Tobit模型(选读)
习题
附录
第15章短面板
15.1面板数据的特点
15.2面板数据的估计策略
15.3混合回归
15.4个体固定效应模型
15.5时间同定效应
15.6一阶差分法
15.7随机效应模型
15.8组间估计量
15.9拟合优度的度量
15.10非平衡面板
15.11究竟该用固定效应还是随机效应
模型
15.12个体时间趋势
15.13短面板的Stata命令及实例
习题
第16章长面板与动态面板
16.1长面板的估计策略
16.2面板校正标准误
16.3仅解决组内自相关的FGLS
16.4全面FGLS
16.5组间异方差的检验
16.6组内自相关的检验
16.7组间同期相关的检验
16.8变系数模型
16.9面板工具变量法
16.10豪斯曼—泰勒估计量(选读)
16.11动态面板
16.12动态面板的Stata命令及实例
16.13偏差校正LSDV法
16.14重复截面数据与组群分析
习题
第17章非线性面板
17.1面板二值选择模型
17.2面板二值选择模型的随机效应估计
17.3面板二值选择模型的固定效应估计
17.4面板二值选择模型的Stata实例
17.5面板泊松回归
17.6面板负二项回归
17.7面板计数模型的Stata实例
17.8面板Tobit
17.9面板随机前沿模型
习题
第18章随机实验与自然实验
18.1实验数据
18.2理想的随机实验
18.3引入更多的解释变量
18.4随机实验执行过程中可能出现的问题
18.5自然实验
18.6双重差分法
18.7三重差分法
18.8观测数据的处理效应
习题
第19章蒙特卡罗法与自助法
19.1蒙特卡罗法的思想与用途
19.2蒙特卡罗法实例:模拟中心极限定理
19.3蒙特卡罗法实例:服从卡方分布的扰动项
19.4蒙特卡罗积分
19.5最大模拟似然法与模拟矩估计
19.6自助法的思想与用途
19.7自助法的分类
19.8使用自助法估计标准误
19.9使用自助法进行区间估计
19.10使用自助法进行假设检验
19.11自助法的一致性(选读)
19.12异方差情况下的自助法
19.13面板数据与时间序列的自助法
19.14自助法的Stata命令
19.15使用自助法进行稳健的豪斯曼检验
习题
附录
第20章平稳时间序列
20.1时间序列的数字特征
20.2自回归模型
20.3移动平均模型
20.4ARMA
20.5自回归分布滞后模型
20.6ARMA模型的Stata命令及实例
20.7误差修正模型
20.8MA(∞)与滞后算子
20.9向量自回归过程
20.10VAR的脉冲响应函数
20.11预测误差的方差分解
20.12格兰杰因果检验
20.13面板格兰杰因果检验
20.14VAR的Stata命令及实例
20.15季节调整
习题
第21章单位根与协整
21.1非平稳序列
21.2ARMA的平稳性
21.3VAR的平稳性
21.4单位根所带来的问题
21.5单位根检验与平稳性检验
21.6单位根检验的Stata实例
21.7面板单位根检验
21.8协整的思想与初步检验
21.9Beveridge—Nelson分解公式
21.10协整的定义与最大似然估计
21.11协整分析的Stata实例
习题
附录
第22章自回归条件异方差模型
22.1条件异方差模型的例子
22.2ARCH模型的性质
22.3ARCH模型的MLE估计
22.4GARCH模型
22.5何时使用ARCH或GARCH模型
22.6ARCH与GARCH模型的扩展
22.7ARCH与GARCH的Stata命令及实例
22.8多维GARCH模型(选读)
习题
第23章似不相关回归
23.1单一方程估计与系统估计
23.2似不相关回归的假定
23.3SUR的FCLS估计
23.4SUR的假设检验
23.5似不相关回归的Stata命令及实例
23.6变系数面板数据的SUR估计
习题
附录
第24章联立方程模型
24.1联立方程模型的结构式与
简化式
24.2联立方程模型的识别
24.3单一方程估计法
24.4三阶段最小二乘法
24.5三阶段最小二乘法的Stata实例
24.6结构VAR
24.7SVAR的Stata实例
习题
第25章非线性回归与门限回归
25.1非线性最小二乘法
25.2非线性回归的Stata命令及
实例
25.3门限回归
25.4面板数据的门限回归
25.5门限回归的计算机操作
习题
第26章分位数回归
26.1为什么需要分位数回归
26.2总体分位数
26.3样本分位数
26.4分位数回归的估计方法
26.5分位数回归的Stata命令及实例
习题
第27章非参数与半参数估计
27.1为什么需要非参数与半参数估计
27.2对密度函数的非参数估计
27.3核密度估计的性质
27.4最优带宽
27.5多元密度函数的核估计
27.6非参数核回归
27.7多元核回归
27.8k近邻回归
27.9局部线性回归
27.10非参数估计的Stata命令及实例
27.11半参数估计
习题
附录
第28章处理效应
28.1处理效应与选择难题
28.2通过随机分组解决选择难题
28.3依可测变量选择
28.4匹配估计量的思想
28.5倾向得分匹配
28.6倾向得分匹配的Stata实例
28.7偏差校正匹配估计量
28.8双重差分倾向得分匹配
28.9断点回归的思想
28.10精确断点回归
28.11模糊断点回归
28.12断点回归的Stata实例
28.13处理效应模型
习题
第29章空间计量经济学
29.1地理学第一定律
29.2空间权重矩阵
29.3空间自相关
29.4空间自回归模型
29.5空间杜宾模型
29.6空间误差模型
29.7一般的空问计量模型
29.8含内生解释变量的SARAR模型
29.9空间面板模型
29.10空间计量方法的局限性
第30章久期分析
30.1久期数据的处理方法
30.2风险函数
30.3久期数据的归并问题
30.4描述性分析
30.5久期模型的最大似然估计
30.6比例风险模型
30.7加速失效时间模型
30.8Cox模型
30.9比例风险模型的设定检验
30.10分层Cox模型
30.11随时间而变的解释变量
30.12不可观测的异质性
30.13其他久期分析模型
30.14久期分析的Stata命令及实例
习题
第31章贝叶斯估计简介
31.1贝叶斯估计的思想
31.2贝叶斯定理
31.3贝叶斯估计的一个例子
31.4基于后验分布的统计推断
31.5先验分布的选择
316多元回归的贝叶斯分析
31.7马尔可夫链蒙特卡罗法
习题
第32章如何做规范的实证研究
32.1计量理论与现实数据
32.2实证研究的主要步骤
32.3实证论文的结构
32.4计量实践的十诫
32.5结束语
习题
附录:常用数据来源
参考书目
数学符号
英文缩写


评论0